반응형
DR(Disaster Recovery) 재해복구
:재해발생시 다른 지역의 시스템을 옮겨서 복구
CDC(Change Data Capture)
: DR을 구성하기 위한 데이터 복제 방법 중 하나
변경 트랜잭션만 Redo log로부터 추출
시스템의 부하를 최소로 하며 분산프로세스 처리가 용이
시스템이 갑자기 꺼지거나 깨졌을 때, 이미 완료(Commit)되었으나 디스크에 완전히 반영되지 못한 데이터를 다시 실행(Redo)하여 복구하며, 트랜잭션의 영구적 보장(ACID의 Durability)을 유지하는 핵심 역할로, 변경된 데이터를 매번 느린 디스크의 데이터 파일에 직접 쓰지 않고, 상대적으로 빠른 로그 파일에 먼저 기록해 성능을 높임.
- Redo log(리두 로그)
: 데이터베이스에서 데이터 변경 사항을 순서대로 기록하여 장애 발생 시 복구에 사용하는 파일
- Undo Log(언두 로그)
: 이전 데이터를 보관해 트랜잭션을 취소(Rollback)하거나 읽기 일관성을 유지하기 위한 목적의 파일
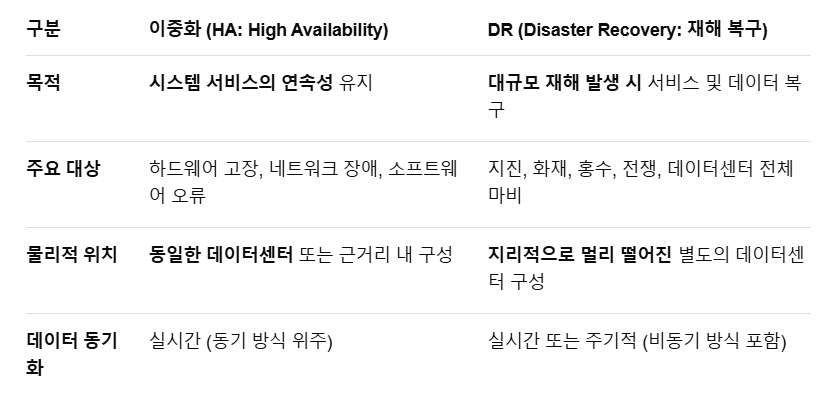
[장애 발생시]
1. 영향력을 분석하여 우선순위를 정함.
2. 복구 목표를 정하고 그 범위를 정하여 백업, 복구를 시험.
[장애 대응을 위한 DB 구성]
DB를 Active-Active 또는 Active-Standby 구조로 구성하는 것이 인프라 구축의 핵심 표준
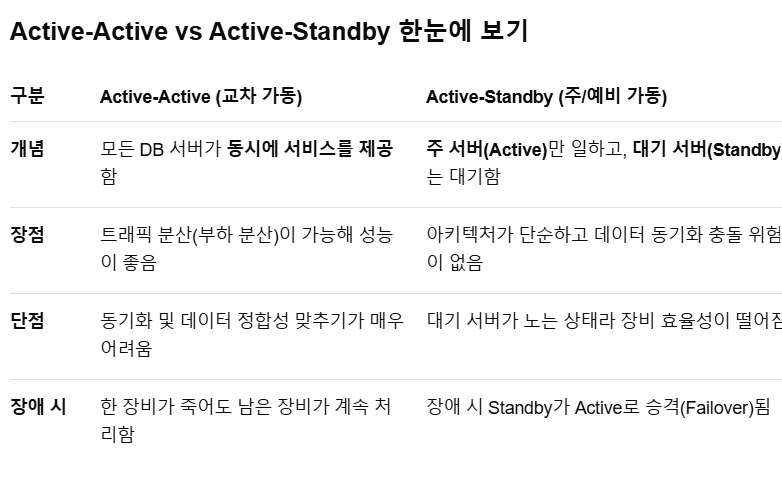
1. Active-Standby (가장 보편적인 방식)
평소에는 1번 DB(Active)만 모든 읽기/쓰기 요청을 처리하고, 2번 DB(Standby)는 1번의 변경 사항(앞서 언급한 리두 로그나 바이너리 로그)을 복사하며 실시간으로 대기만 합니다.
- 장애 대응: Active DB가 죽으면, Standby DB가 지휘권을 이어받아(Active로 승격) 서비스를 계속합니다.
2. Active-Active (고성능/고가용성 방식)
여러 대의 DB 서버가 동시에 켜져서 사용자들의 요청을 나누어 처리합니다.
- 장애 대응: 서버 하나가 죽어도 다른 서버들이 살아있기 때문에 서비스가 끊기지 않습니다. 다만, 남은 서버들로 트래픽이 몰리므로 과부하를 고려해야 합니다.
- 구현 방식:
- 공유 스토리지 방식: 여러 DB 엔진이 하나의 데이터 저장소를 바라봄 (예: Oracle RAC)
- 데이터 분산 방식: 각 DB가 자체 저장소를 가지고 서로 양방향 복제를 함 (동기화 지연 및 충돌 제어가 매우 까다로움)
[실무에서의 절충안: Active-Read Replicas]
완전한 Active-Active는 난이도가 너무 높기 때문에, 실무에서는 쓰기(Write)는 Active(Master) 1대에서만 하고, 읽기(Read)는 여러 대의 Standby(Slave) 서버들이 나누어 처리하는 구조(Query Offloading)를 가장 많이 사용합니다.
반응형
'시고또' 카테고리의 다른 글
| 요구사항 정의서, 요구사항추적표,RACI표,리스크 관리대장,이슈대장 (0) | 2026.09.23 |
|---|---|
| Data Integrity 검증 방법 (0) | 2026.09.20 |
| 네트워크 L3 / L4 / San Switch 차이점 과 Storage, 무선 AP (0) | 2026.09.19 |
| AI 활용을 위한 일잘러 프롬프트 (2) | 2026.08.24 |
| PgMP (Program Management Professional) (0) | 2026.08.22 |